ZONOS3-Mini 开放权重:支持中文与逐词语气控制,语音克隆可在浏览器本地运行
Zyphra 近期公开 ZONOS3-Mini 语音合成模型及多种运行时,11月12日又在 Hugging Face 发布技术说明。模型支持包括普通话在内的43种语言,主干每次激活约1亿参数、总参数约8亿;权重采用 Apache 2.0,运行时代码采用 MIT 许可,并提供 WebGPU 与 Apple Silicon 路径。
把语音克隆与表达控制放进可本地运行的小模型
Zyphra 公开了 ZONOS3-Mini,一款面向多语言语音合成、零样本声音克隆和表达控制的模型。官网文章标注11月9日;Hugging Face 技术页显示11月12日发布,正文署名行另列11月11日。本文按不同页面分别保留日期,不把后续技术说明当作今天首次推出。
模型覆盖43种语言,列表包含普通话、日语和韩语。它用已有参考音频或说话人表示来生成目标声音,同时允许调整语气与表达。这里的交付物包括权重、推理代码和试用入口,适合希望把语音合成接入产品的开发者;语言被支持并不等于每种口音和文本都有相同质量。
一亿激活参数与八亿总参数代表不同的部署成本
官方将其描述为稀疏混合专家模型,主干总参数约8亿、每个Token激活约1亿。模型卡还列出音频编解码器、说话人编码及生成过程,不能把激活参数数目直接当作全部下载大小或内存占用。实际运行仍须装入对应权重与解码组件。
GitHub README 给出的CUDA默认路径包含语言模型、自动编码器和说话人编码器,相关权重合计约9GB;MLX、C++和浏览器使用另外的GGUF或Web文件。因而“Mini”描述的是模型与计算设计,不是所有硬件都能无条件快速启动,更不是下载一个百兆文件就完成部署。
浏览器、Apple Silicon和服务端各有运行入口
官方仓库按机器类型列出不同后端:NVIDIA GPU上的CUDA服务、Apple Silicon上的MLX、支持CPU及多种加速后端的C++/ggml,以及无需服务端的WebGPU浏览器路径。开发者可先选目标硬件,再沿对应目录安装;这些后端共享HTTP接口与Voice Studio界面。
README提供兼容OpenAI风格的 /v1/audio/speech 接口,也有原生 /v2/generate 和离线Python调用方式。首次CUDA启动需要即时编译,文档明确可能花费数分钟。本站没有安装模型或试听生成结果,本文只确认公开入口及文档描述,不声称完成了端侧速度实测。
逐词控制有明确机制,也仍是生成目标
技术说明将声音身份与表达控制分开:说话人表示用于声音特征,推理时的激活引导用于语速、情绪、投射感和活跃度。模型还通过对齐注意力头定位词语,在流式生成过程中对指定片段施加表达控制,而不必只对整句话统一调整。
官方演示也说明这些旋钮并非完全独立:语速调整可能同时影响音高或响度,情绪设置是目标而非确定保证。仓库将语音编辑等列为可选能力,不同后端涉及专用检查点、适配器或对齐组件,不能把基础文本转语音服务等同于所有编辑功能都已开箱可用。
权重与代码许可分开,延迟数字保留测试条件
官方模型卡标注权重为Apache 2.0,GitHub LICENSE为MIT,第三方组件另外列在NOTICE及许可证目录。开放权重与运行时代码可以单独核对;它们不能自动推导出托管API免费,也不替使用者取得任意参考声音的使用授权。
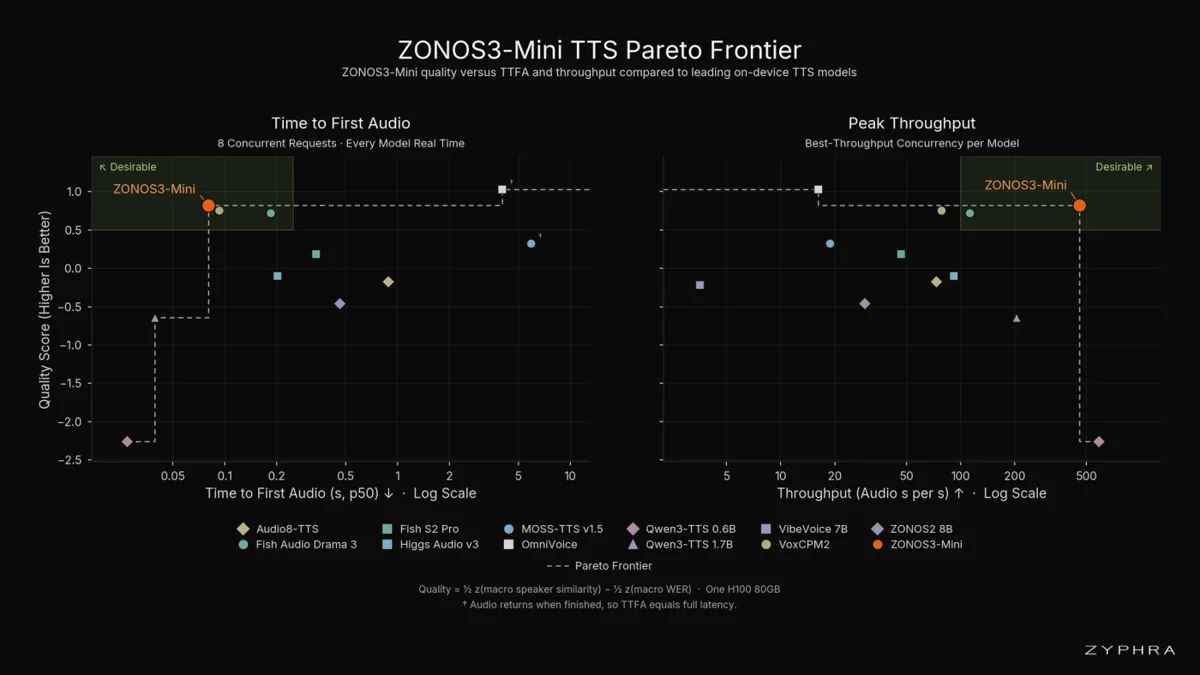
发布方报告在Pixel 9浏览器中首段音频时间低于570毫秒,在M3 MacBook Air上低于150毫秒。这些数字来自其特定设备测试,不能推广为任意浏览器或设备的承诺。配图中的H100延迟和吞吐也属于官方指定并发及质量指标下的比较,本站未独立复现。
原始来源
- Zyphra 官方发布文章 ↗官方公告 · 2026/11/09 · Gabriel Clark、Sofian Mejjoute、George Close、Beren Millidge
- Zyphra 技术说明(Hugging Face) ↗官方公告 · 2026/11/12 · Gabriel Clark、Sofian Mejjoute、George Close、Beren Millidge
- Zyphra 官方运行时 README(11月12日更新版本) ↗官方公告 · 2026/11/12
本文为基于公开资料的中文整理;编辑观察为本站分析,不代表来源方观点。